Unicode外观相同,为何比较失败?
两个文字视觉相同,不代表它们的Unicode序列完全相同。带重音字母可能使用预组合字符,也可能由普通字母加组合标记组成。做唯一性判断、搜索或摘要计算前,应明确是否采用一致的规范化策略,避免只凭肉眼认为原文相同。
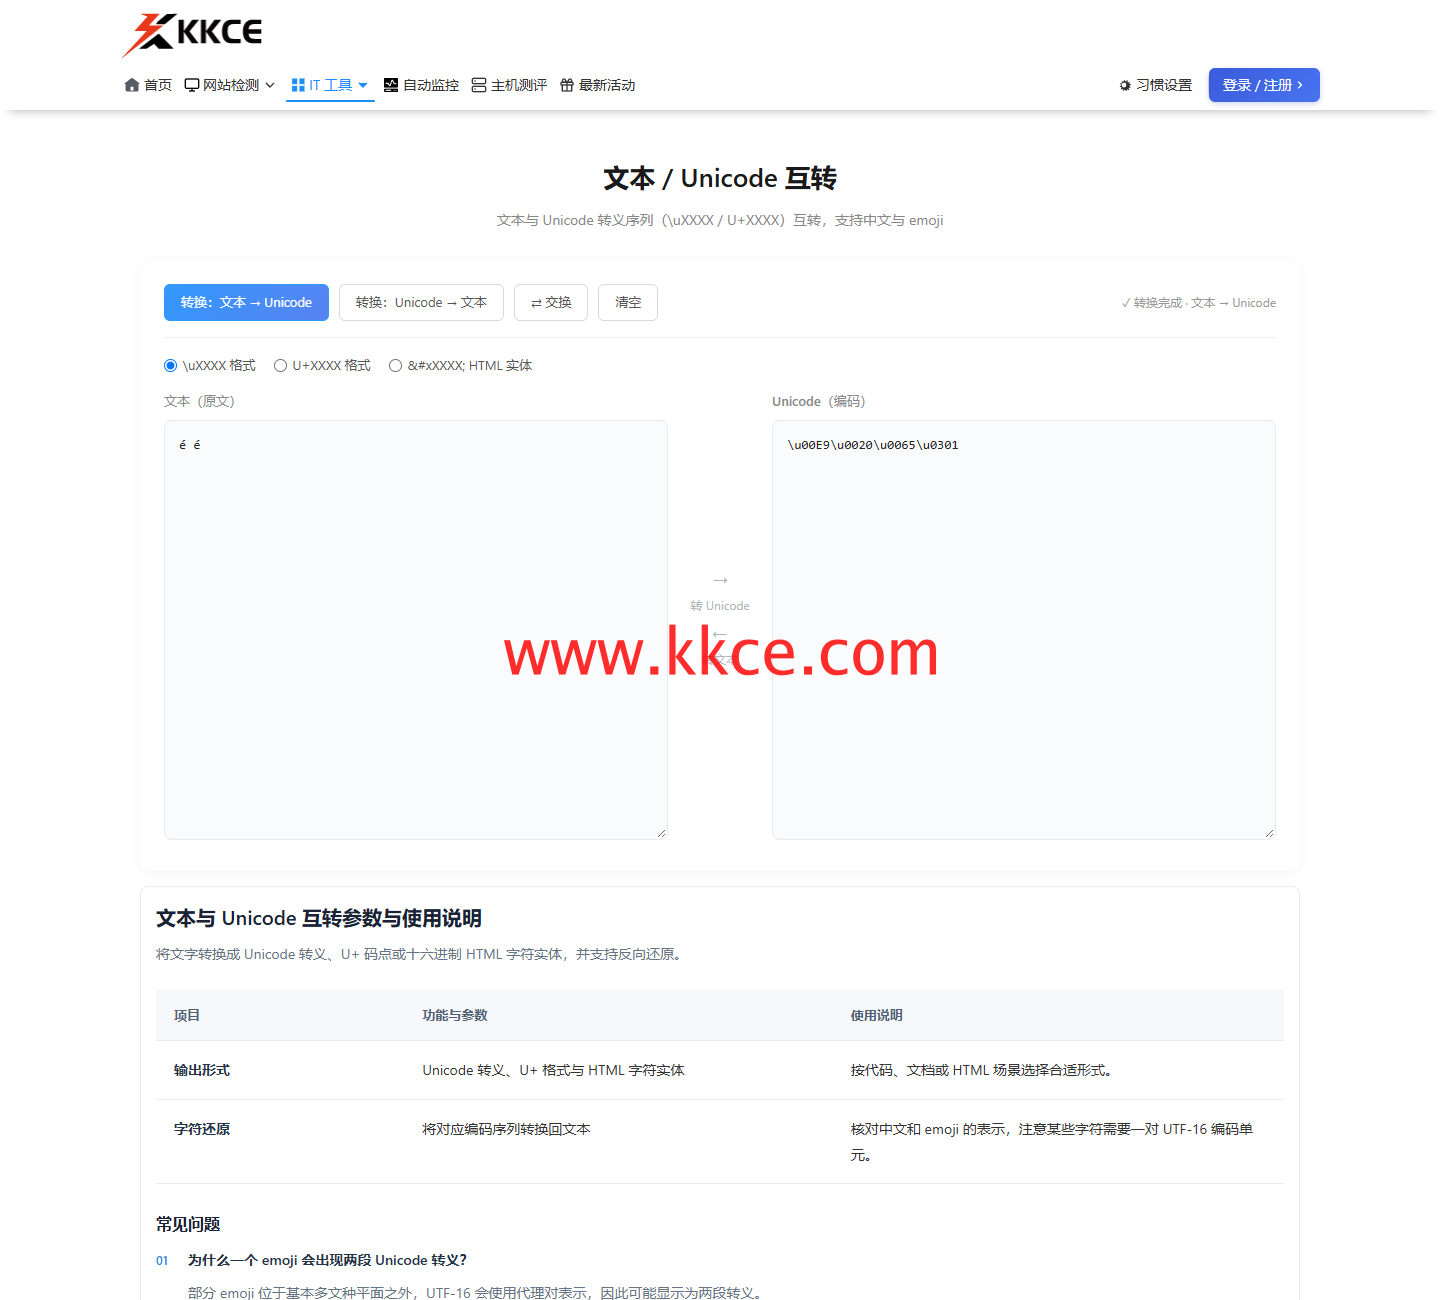 2026年11月7日,www.kkce.com 实拍。两种Unicode拼写由本次人工构造,实际输出四段转义;未声称所有外观相似字符都可规范化成同一内容。
把两种形式放在同一输入里
本次在KKCE字符序列页面输入两种é,中间用空格区分。实际转义结果显示前者是00E9,后者由0065和0301组成;0020对应中间空格。截图保留真实序列差别,而不是依靠改变字体制造不同。
码点组合与字体表现不同层
字体可能把多个码点组合显示为一个字形,字符串的原始比较仍会看到差异。长度、光标移动及截断行为也可能受表示方式影响。错误报告宜保存可复现的码点信息,不要仅附一张两段文字相似的图片。
规范化必须有明确适用边界
NFC等形式可帮助处理某些规范等价关系,但不是所有相似外观都能被统一,也不应擅自改变协议中的原始输入。涉及密码、签名或用户标识时,按既定规则处理,并考虑兼容已有数据,而非临时在一端加一步转换。
输入保存与检索分别做验证
检查输入法、数据库和搜索索引是否采用相容策略,再覆盖组合标记的边界样本。KKCE帮助看见不可见差别,是否应该合并两份文本仍由业务决定。维护说明应记录保留原文还是使用哪种规范化形式。
下一篇:
日期中的星期为何显示不对?