UTF-8文件开头的BOM是什么?
UTF-8文件开头的EF BB BF通常是BOM,它对应一个开头的Unicode标记,日常阅读时往往看不到。UTF-8不需要靠它确定字节序,但软件可能用它识别编码。检查文件内容差异时,应把原始字节与解码后显示的文字分别核对。
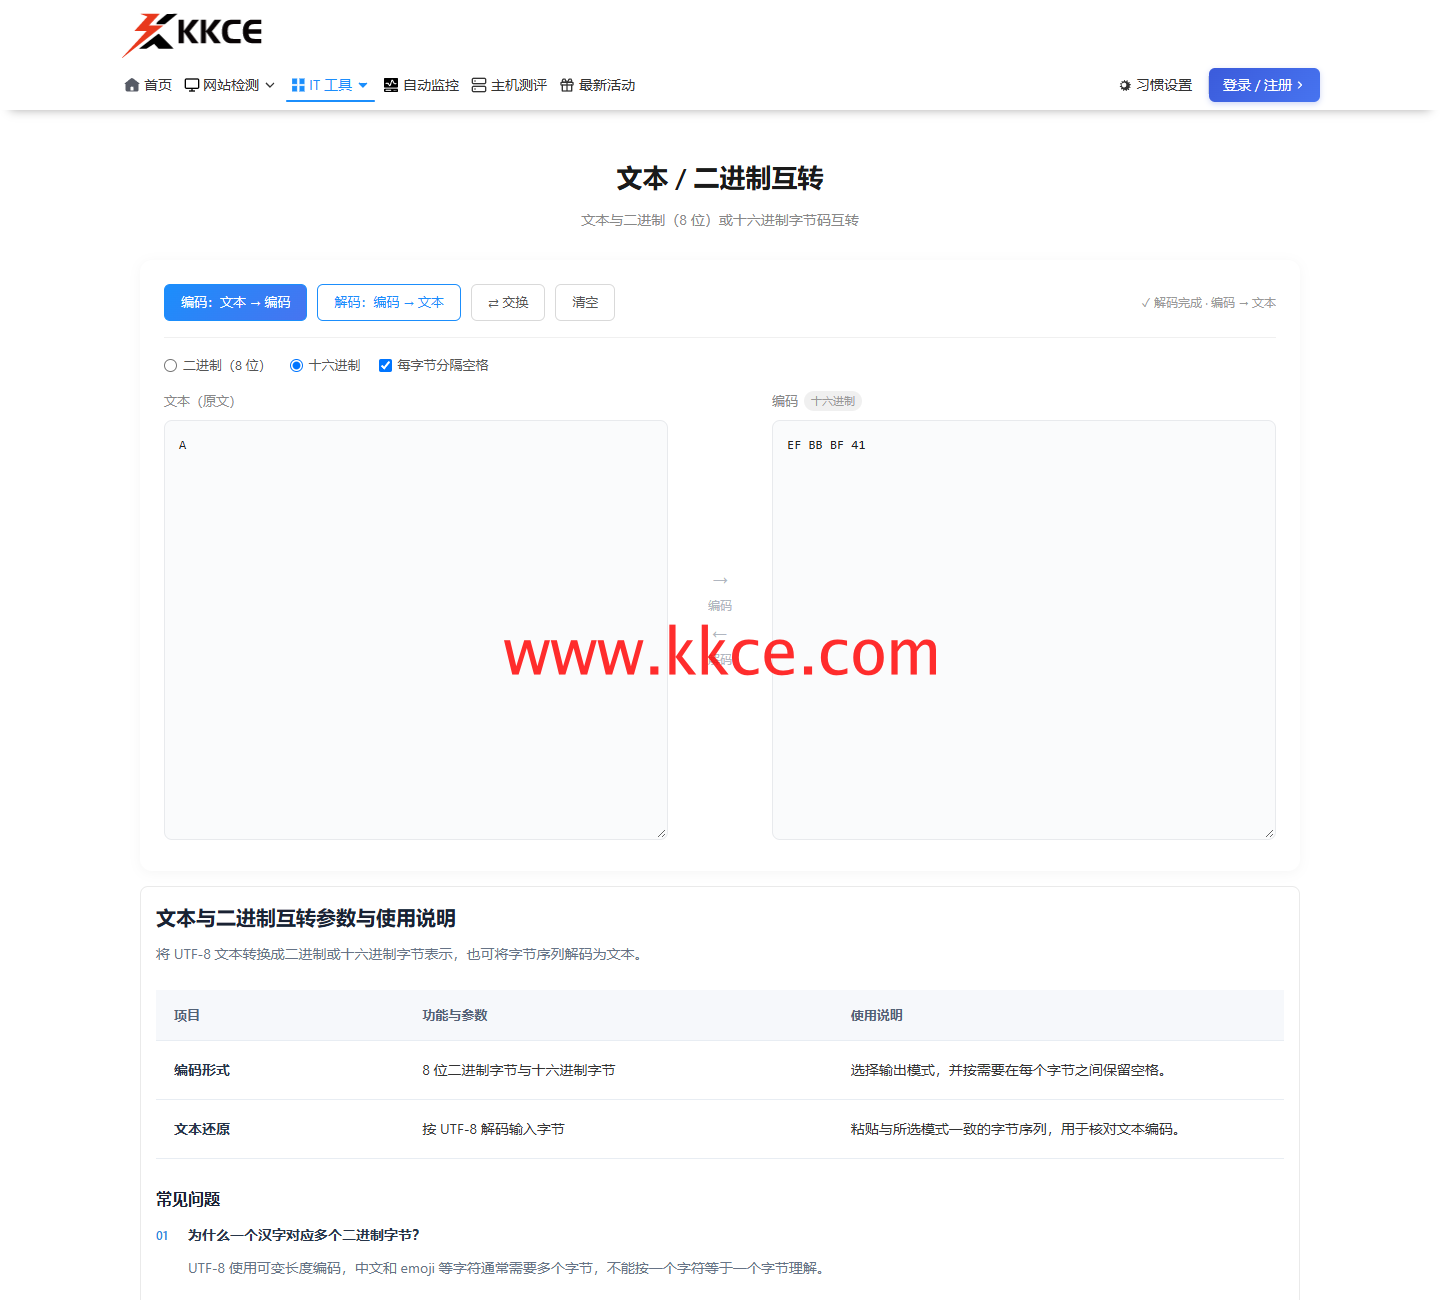 2026年11月7日,www.kkce.com 实拍。人工输入EF BB BF 41;解码输出实际为A,工具在该位置消费了BOM。未操作任何用户文件。
解码样例只显示了一个字母
本次进入KKCE文本与二进制互转,选择十六进制并输入EF BB BF 41,执行解码后左侧显示A。该页面此次解码处理了开头标记,因此没有把它作为可见内容展示。截图说明的是本工具的表现,不代表所有编辑器都会删除或隐藏同样的字节。
看不见不意味着文件没有差别
一个带BOM、一个不带BOM的文件,即使正文相同,逐字节比较也会不同。哈希和文件体积也可能随之变化。若只复制屏幕上看到的文字再计算,就可能丢掉原文件的重要条件,应优先检查原始文件或保留字节的读取方式。
接收程序对文件头有各自约定
某些导入器会主动消费标记,另一些程序可能把它当成首字段的一部分,造成列名或首个键不匹配。脚本、配置和接口输入应按接收规范导出,不宜一律增加或一律去除。先在小样本中确认行为,再决定批量转换策略。
保留往返过程的可核对性
快快测可辅助阅读UTF-8字节与文字关系,不能仅凭显示结果判断原文件是否被原样保存。记录输入字节、解码选项和再次导出后的文件头,检查是否发生规范化。对归档和完整性校验场景,应将是否保留BOM写入明确要求。
上一篇:
Markdown列表为何从1开始?