
Unicode转义为何仍显示原文?
写出反斜杠和u开头的字符序列,不保证任何页面都会把它解释成对应文字。只有在支持这类转义的语法或转换步骤中,它才具有特定含义。传输、序列化和界面展示可能让它继续保持字面形式,应先确认数据经过哪一层解析,再决定需要怎样转换。
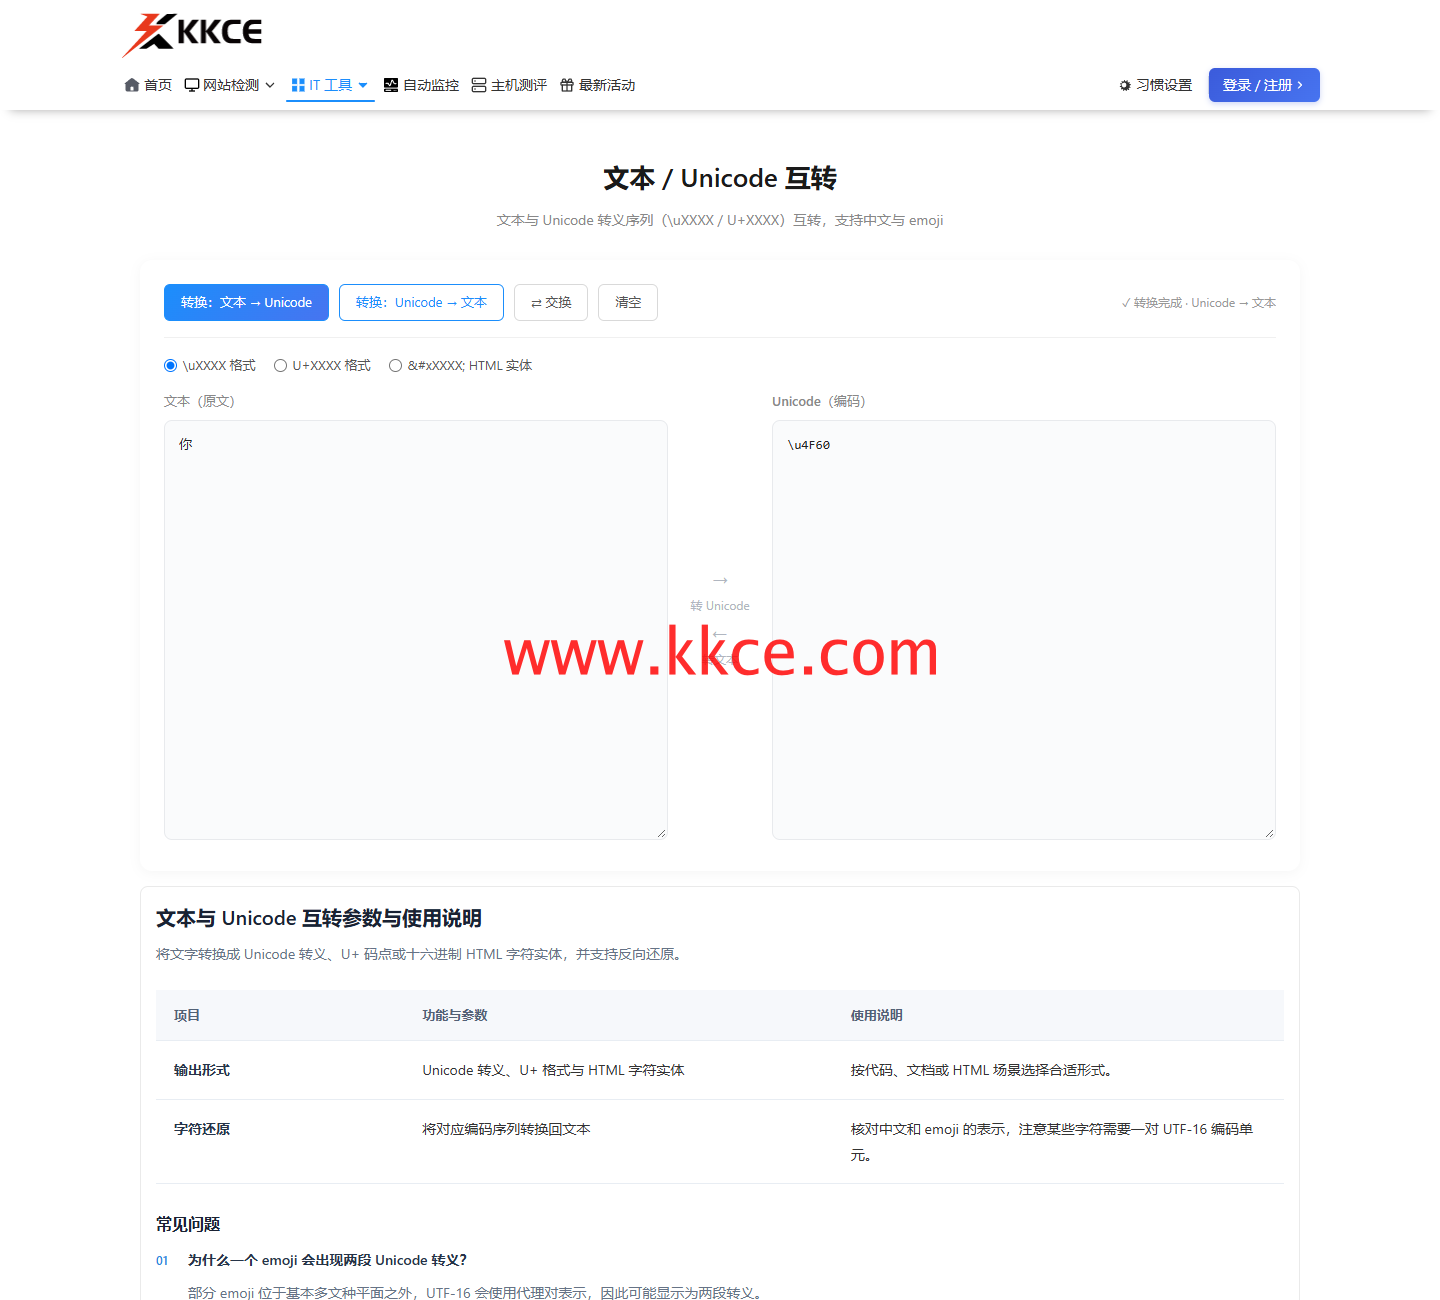 2026年11月7日,www.kkce.com 实操截图。解码侧把字面量转为汉字;另一张图将同样外观作为普通字符逐个编码。
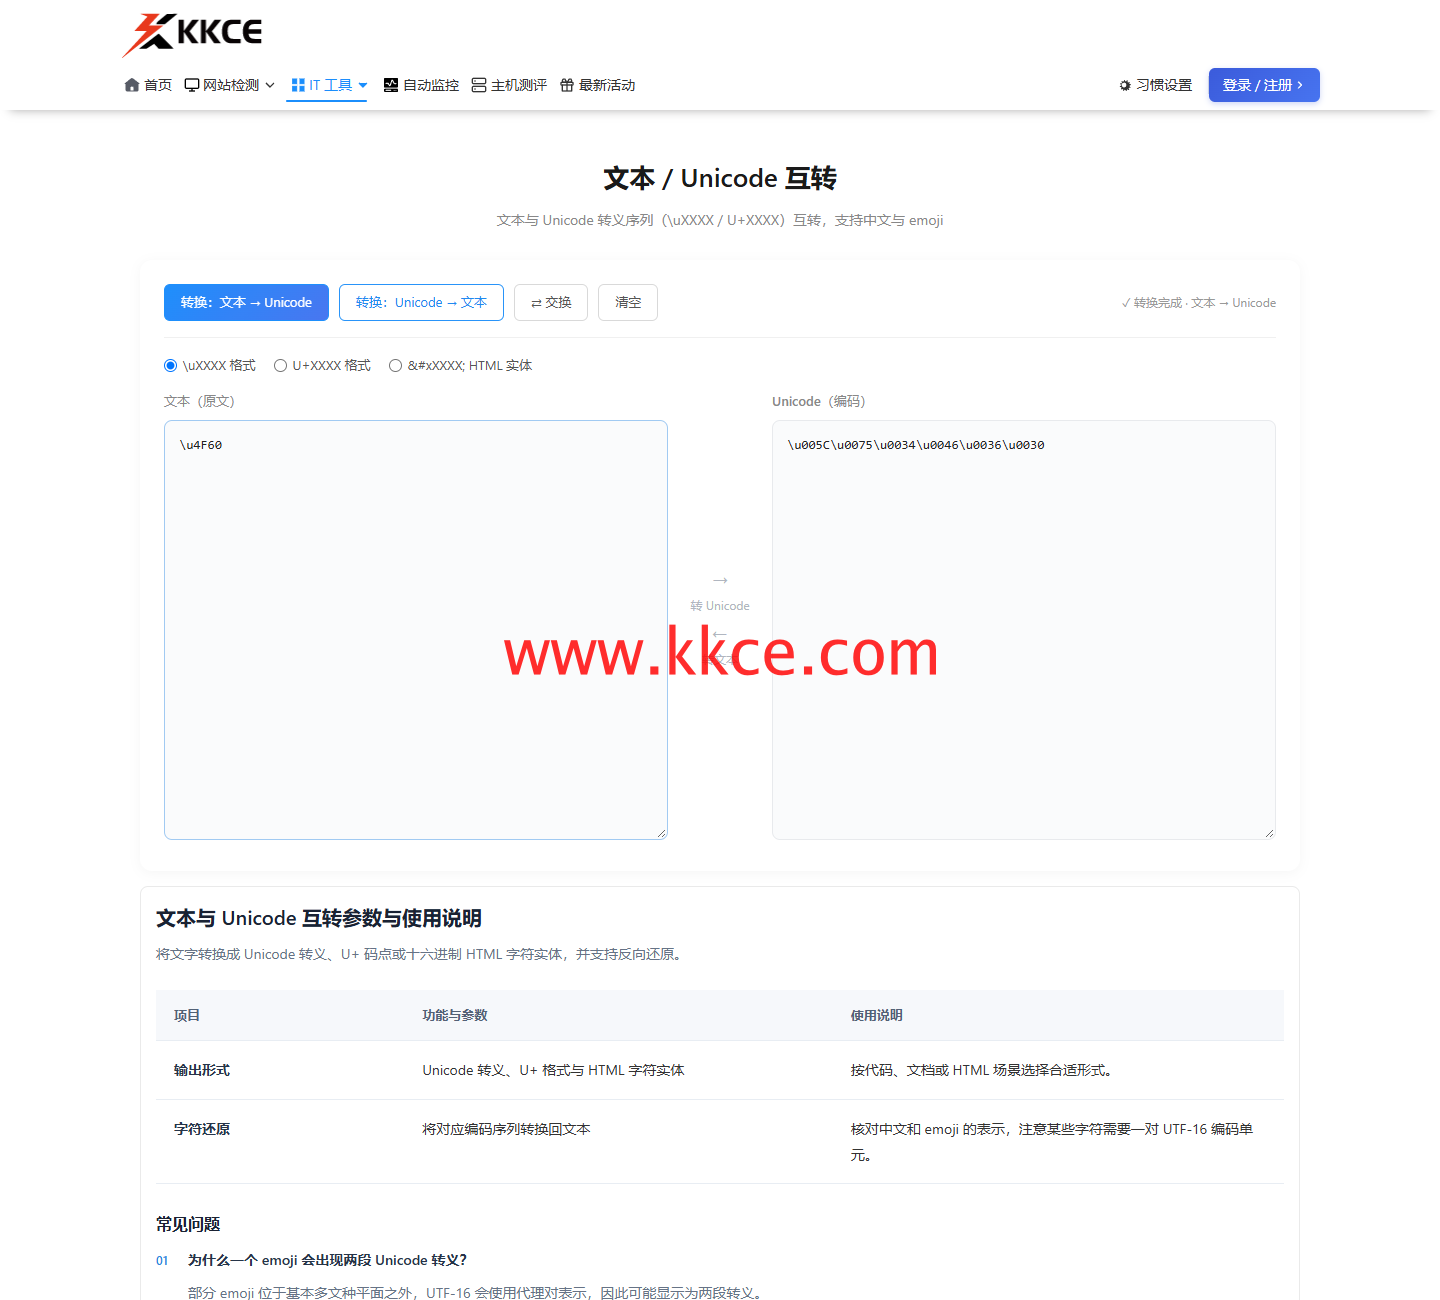 编码方向保留了各字符的身份,不代表工具应自动把它当成汉字。
同一个外观用不同方向处理
在KKCE Unicode转换把字面量\u4F60放入解码侧,可以得到“你”;把这六个可见字符放入编码侧,则逐个编码反斜杠、u和数字。配图展示这两种方向,说明按钮承担的规则不同,并非相同输入在任意位置都会自动还原。
程序源码与运行时数据不能混看
某些语言会在读取源码字符串时解释转义,文件或网络返回的普通文字则未必经历同一步。调试器还可能为了展示内容再次增加转义符号。定位时应查看运行时字符及长度,明确看到的是源代码表示、调试表示还是实际数据。
额外序列化会增加表示层次
当一段含反斜杠的文本被装进JSON等格式,序列化器会按其规则保护反斜杠,接收方解析外层后才得到原来的文字。若业务仍需Unicode还原,那是另一项明确约定的操作。不能仅因字符串像转义,就在所有用户输入上无条件再次解释。
以最小样例标出每个边界
列出发送前字符、线上表示和接收后字符,把每次解析写清楚。快快测适合用公开短文本验证转换方向,真实接口则需核对双方字段合同。先确认预期最终应是汉字还是六个字面字符,才能判断当前展示是否错误。
上一篇:
字段改驼峰,旧接口会兼容吗?
下一篇:
换行看着一样,字节为何不同?
