测试文本分成多行时,正则里的行首、行尾与点号不一定按直觉工作。应分别确认锚点是否针对每一行,以及点号能否跨越换行,再决定全局提取策略。KKCE正则页面可以把测试文本、匹配高亮和分组结果放在一起观察。
先定义每条记录的边界
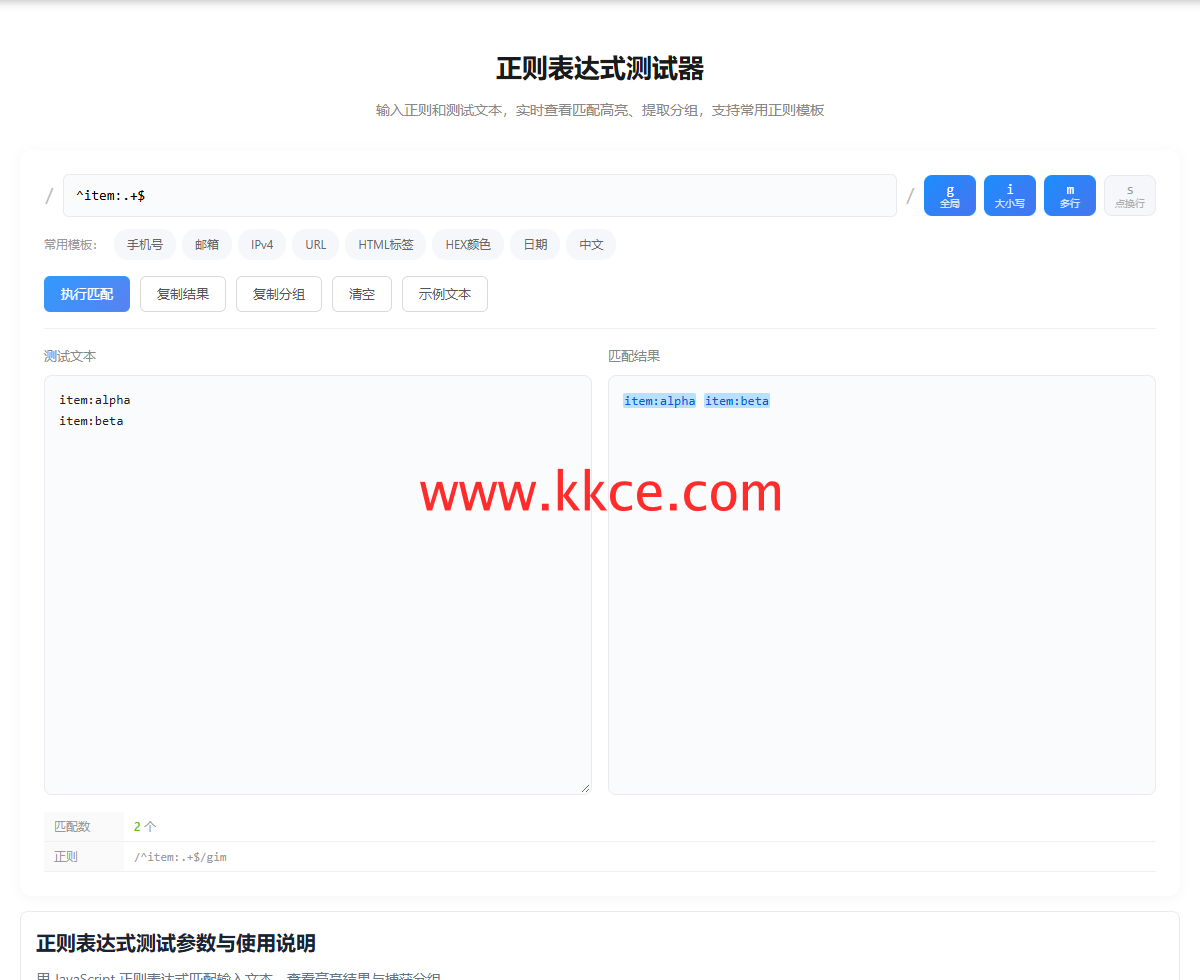
本次构造两条文本:item:alpha与item:beta,中间用换行分隔。表达式使用^item:.+$,目的是识别以item:开头的记录,而不是查找任意位置出现的片段。此时最重要的业务问题是每条记录是否必须单独输出。若日志里还有空行、空值、额外前缀,需要在样本中分别安排,避免只用两条整齐数据就判断规则可靠。
把三个开关的作用分开
全局选项影响是否继续寻找后续命中;多行选项让行首和行尾锚点具有逐行语义;点匹配换行选项改变点号覆盖的字符范围。它们解决的是不同问题。需要逐行提取时,通常不能简单开启所有开关,因为跨行点号配合贪婪量词可能把多条记录吞成一整段。应先确定所需边界,再增加必要的行为。
在工作区观察实际命中
打开官网测试页后填入上述表达式与两行样本,执行匹配,并对照高亮范围及页面列出的选项。截图只记录这一次页面状态。随后可在同一个样本上单独切换多行或点换行,再看命中是否越过行界。改变一个条件后立即比较,比同时修改表达式、文本和选项更容易判断变化来源。
从示例迁移到真实日志
实际输入可能采用不同的换行表示,也可能包含尾部空格。规则还会受正则引擎及执行接口影响,因此应使用与部署端一致的样本重新跑一遍。对可能很长或结构复杂的文本,另行评估表达式性能,不把网页里的短样本响应速度当作大规模日志处理性能。保留预期命中与预期不命中的列表,才便于后续维护。
演示说明:本例说明记录边界的核对方法,不把一条表达式推荐为所有日志格式的通用解析器。
功能入口:正则测试。