两个字符串视觉上相同,底层字符序列却可能不同。例如é可以由单一码点表示,也可以由字母e与组合重音共同构成。比较或计算摘要前,应先明确是否需要Unicode规范化,而不是只根据屏幕显示判断完全一致。
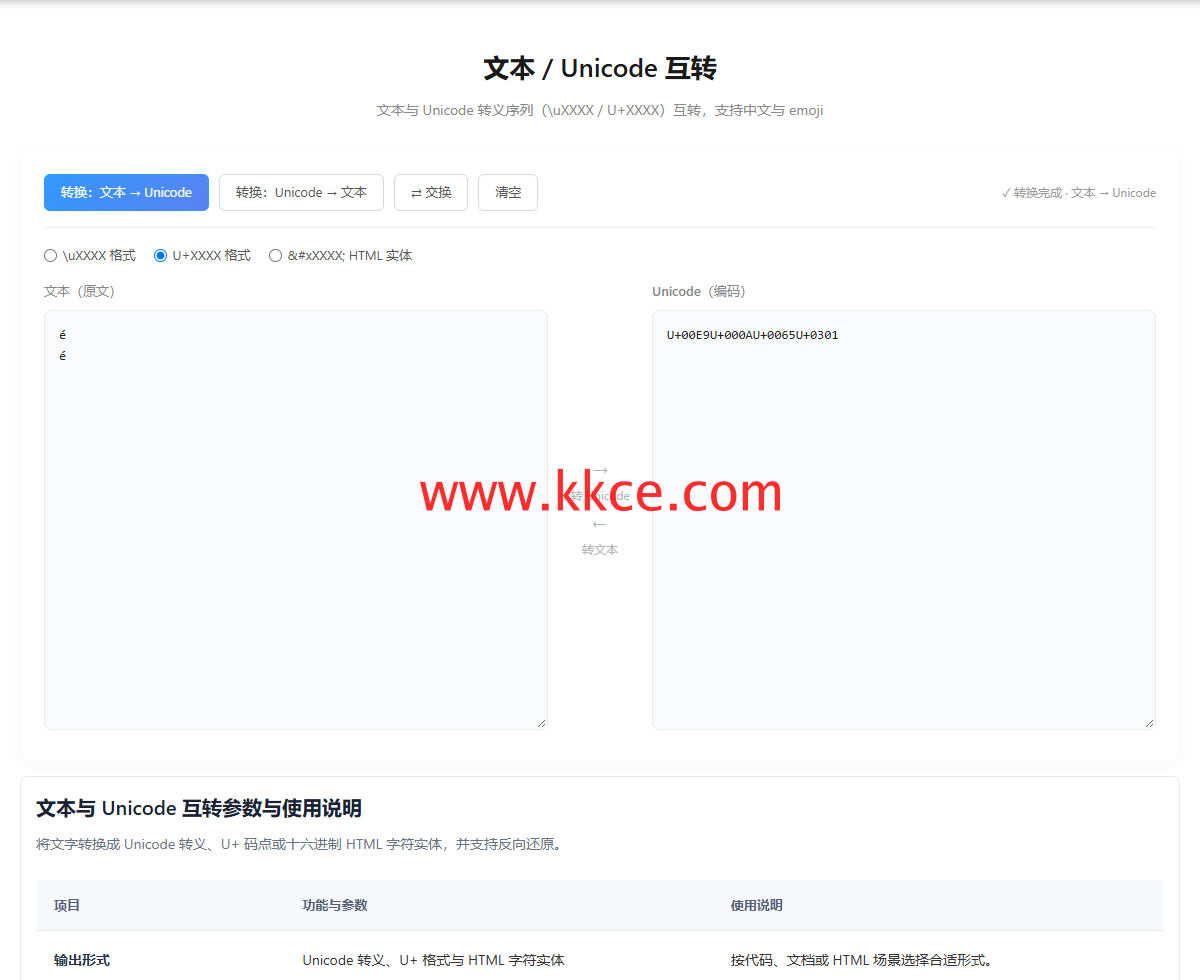
把两种写法放在一起观察
本次输入两行:第一行是预组合字符é,第二行是e后面接组合重音。选择U+形式后,KKCE输出可以区分第一行的U+00E9与第二行的U+0065、U+0301;两行之间还会出现换行本身的码点。图中多出来的换行不是某种额外重音,而是样本排版的一部分。
规范化与编码转换各有任务
Unicode规范化用于按规定处理某些等价字符序列,UTF-8等字符编码则规定如何生成字节。把文本展示成U+形式,主要帮助观察序列,并不自动说明它已经经过NFC等规范化。本轮使用的是字符展示功能,没有把页面当作完整的规范化处理器,也没有据此宣称所有相似字形都能合并成同一个字符。
业务比较需要统一且可解释的策略
搜索、去重、文件名以及数字签名对等价性的要求可能不同。应由业务决定允许哪种规范化,再让写入、查询和比较各环节执行一致的规则。对于需要保留原始文档的场景,可同时保存原文与用于比较的派生值;不能在没有记录的情况下改写原始签名材料,随后又期待认证码仍然相同。
测试不能只覆盖一个重音字母
加入组合标记、表情序列、全角形式与不同语言样本,分别检查字符数量、码点序列和字节长度。它们描述的是不同层次,不应相互代替。某些字符看似相似却没有规范等价关系,登录名防混淆等问题还需要专门设计。KKCE可作为可视化检查入口,最终比较逻辑要在项目实际采用的文本库里验证。
演示说明:这里讨论字符表示差异,不把所有外观相似的文本都认定为同一个身份或标识符。
功能入口:Unicode转换。