
AI访问被拦在哪里?把robots、边缘策略和应用授权分层
AI相关访问受阻,可能来自爬取规则、边缘防护或应用权限。三者目的不同,修复方式也不同。不能为测试一个UA就停用整个站点的访问控制,也不能把规则允许误认为真实访问已经完成。
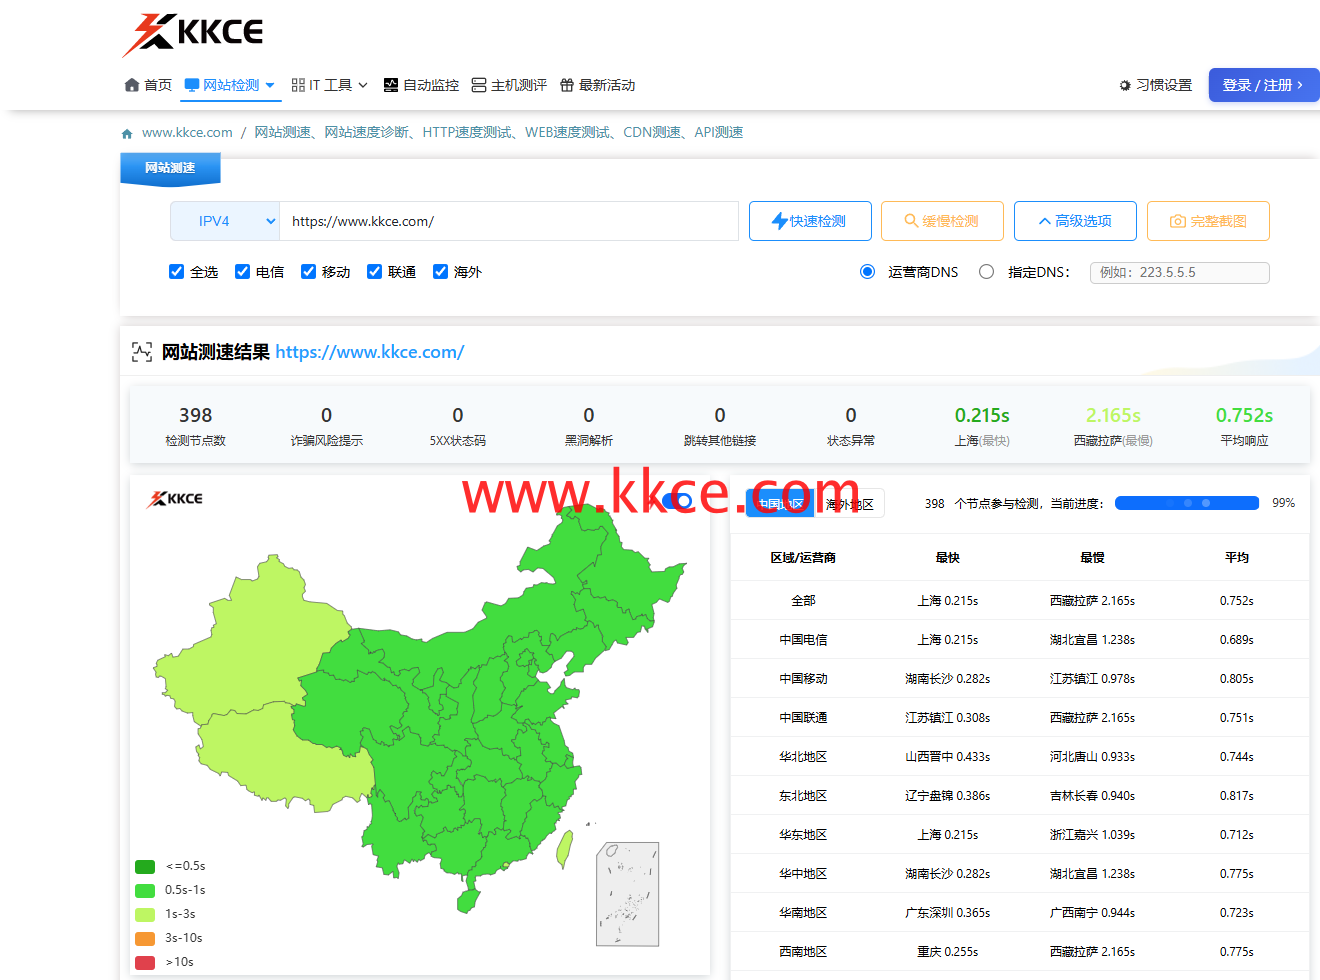 2026年11月7日官网实拍:以KKCE自身公开入口提交网站测速。截图是当次进度和统计的观察样本,仅演示结果区域,不代表本文假设的故障已经发生或已被定位。
规则层决定允许处理哪些路径
先核对目标主机下的机器人规则及需要开放的目录。规则文本不是登录验证系统,敏感资料仍应以真实权限保护。若只希望开放公开新闻,应避免把用户中心和内部接口一并暴露。
网络入口可能有独立防护
CDN与WAF会依据来源、频率和其他信号决定待遇。KKCE HTTP工具可帮助做请求条件对照,但UA并不能确认客户端身份。复查时应以响应标识和时间找到对应防护记录,而非只观察页面颜色。
应用层仍可能输出替代内容
请求被放行后,应用可能继续要求登录、返回简略版本或执行地区跳转。检查公开正文是否直接存在,并确认访问没有循环。授权设计需要保持一致,不能为检索系统额外暴露用户不该看到的内容。
用证据标明每一层的状态
把规则结果、HTTP响应和正文检查分别记录。遇到策略变化时重做同条件对照,再观察真实爬虫日志。对GEO而言,这只能证明技术准备状况,内容被发现与引用仍有外部处理过程。
