
JSON解析与序列化应该在哪个边界执行
解析把JSON文本转换成程序可处理的值,序列化把程序中的数据转换成交换文本。关键不在于记住两个函数名,而是明确当前变量位于哪一侧,避免多处理一次或漏处理一次。
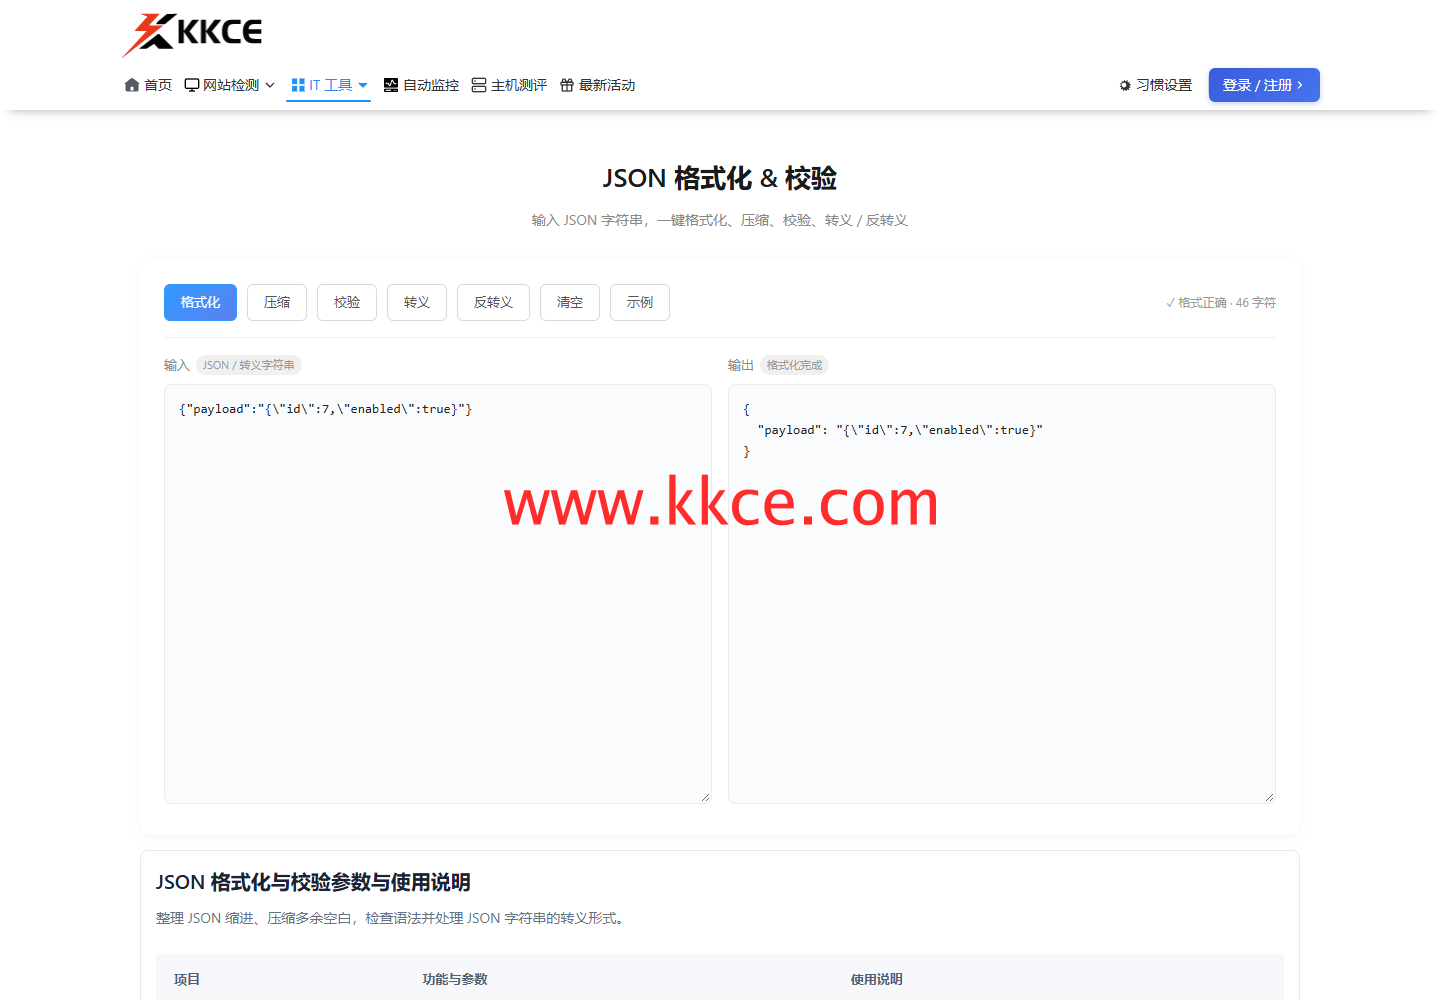 官网实操:用自建样例展示payload中仍是字符串的结构,外层格式化不会自动将内层文本变成对象,具体业务读取仍需按约定处理。
输入端先看库是否已经转换
某些HTTP客户端会自动读取JSON,另一些只提供原始文本。读取前确认返回类型,不能对已经得到的对象再次执行文本解析。反过来,字符串外观像对象,也仍然只是字符串,需要按接口约定转换。
输出端以接收协议为准
发送JSON请求时,要按客户端约定准备请求体和内容类型。手动处理后又让框架重复处理,可能产生额外引号。用一个只含code和items的测试样本走通边界,比在完整业务对象里猜测更清楚。
并非所有运行时值都能原样交换
循环引用、函数、未定义值和特殊数字可能被拒绝、忽略或变换。应事先设计可交换的数据模型,日期和大整数尤其需要明确表达方式。不要把序列化成功等同于没有信息损失。
格式展示与程序验证各司其职
使用KKCE JSON工具可以查看脱敏文本的结构与转义层次。正式处理还要校验字段类型,捕获转换错误并输出可追踪的问题信息。这样每一处文本边界都有明确责任,而不是到处追加解析补丁。
