
Base64解码为何报UTF-8错误?
Base64可以表示任意字节,但解出的字节未必构成有效UTF-8文字。工具提示文本解码失败时,应区分Base64结构不合法与字节无法按指定字符集解释。二进制文件本来就不要求可读,不能把文本转换器的拒绝直接当成原始文件已经损坏。
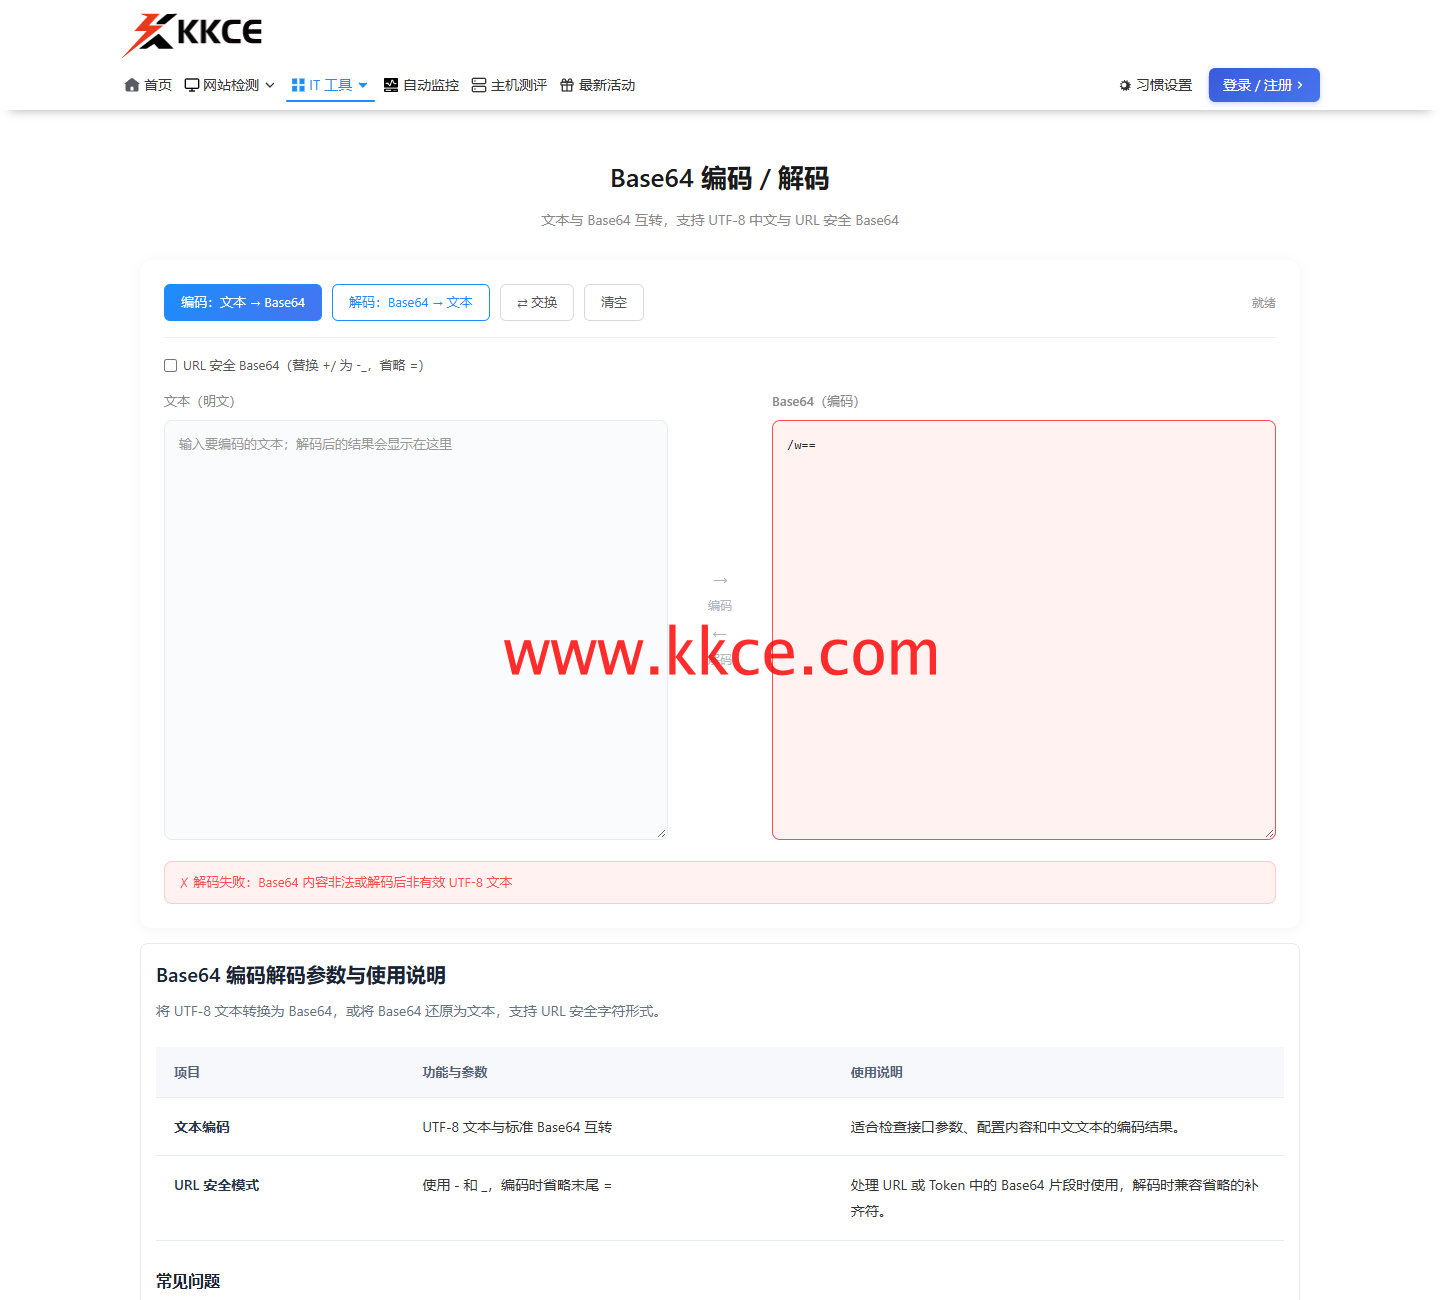 2026年11月7日,www.kkce.com 实操截图。合法Base64样例/w==被文本转换流程拒绝,原因须与UTF-8解释区别分析。
用一个字节隔离错误原因
本次在快快测Base64转换输入/w==,页面提示内容非法或解码后非有效UTF-8文本。该字符串本身是合法Base64,代表单个0xFF字节;这个字节不能独立组成有效UTF-8字符。因此本例应解释为文本解释环节受限,不能断言Base64拼写错误。
字节还原先于字符解释
编码层把二进制内容变成可传递字符,解码层把它还原成字节;文字展示还要根据字符集进一步解释。三步看似都在一个按钮里发生,实际承担不同职责。若来源是压缩包、图片或密文,应按文件格式处理,不必强求出现可读中文。
不要用反复转码掩盖问题
遇到替代字符或空白输出,先查来源协议规定的编码和文件类型。随意换字符集、删除异常字节或重复转换,可能让原有内容无法复原。需要核对时保留原始输入,比较字节长度及受控校验信息,而不是只看显示是否顺眼。
按用途选择验证路径
文字样例适合在KKCE观察编码与解码,二进制内容则应交给能够保留原始字节的流程。业务系统还需明确输入究竟是文件数据还是文字字段。把错误定位到具体层次,才能正确决定是修复传输内容、调整字符集还是改用二进制读取。
上一篇:
HTML转义为何越转越多amp?
下一篇:
日期格式正确,为何仍被拒绝?
