
HTML转义为何越转越多amp?
HTML转义后出现越来越多amp,常见原因是把已经编码的实体再次当作原始文字处理。每轮都会继续处理其中的与号。解决方法是明确原始数据、存储表示和输出上下文之间的边界,让负责展示的一层按规则编码,而不是在每次流转时重复执行。
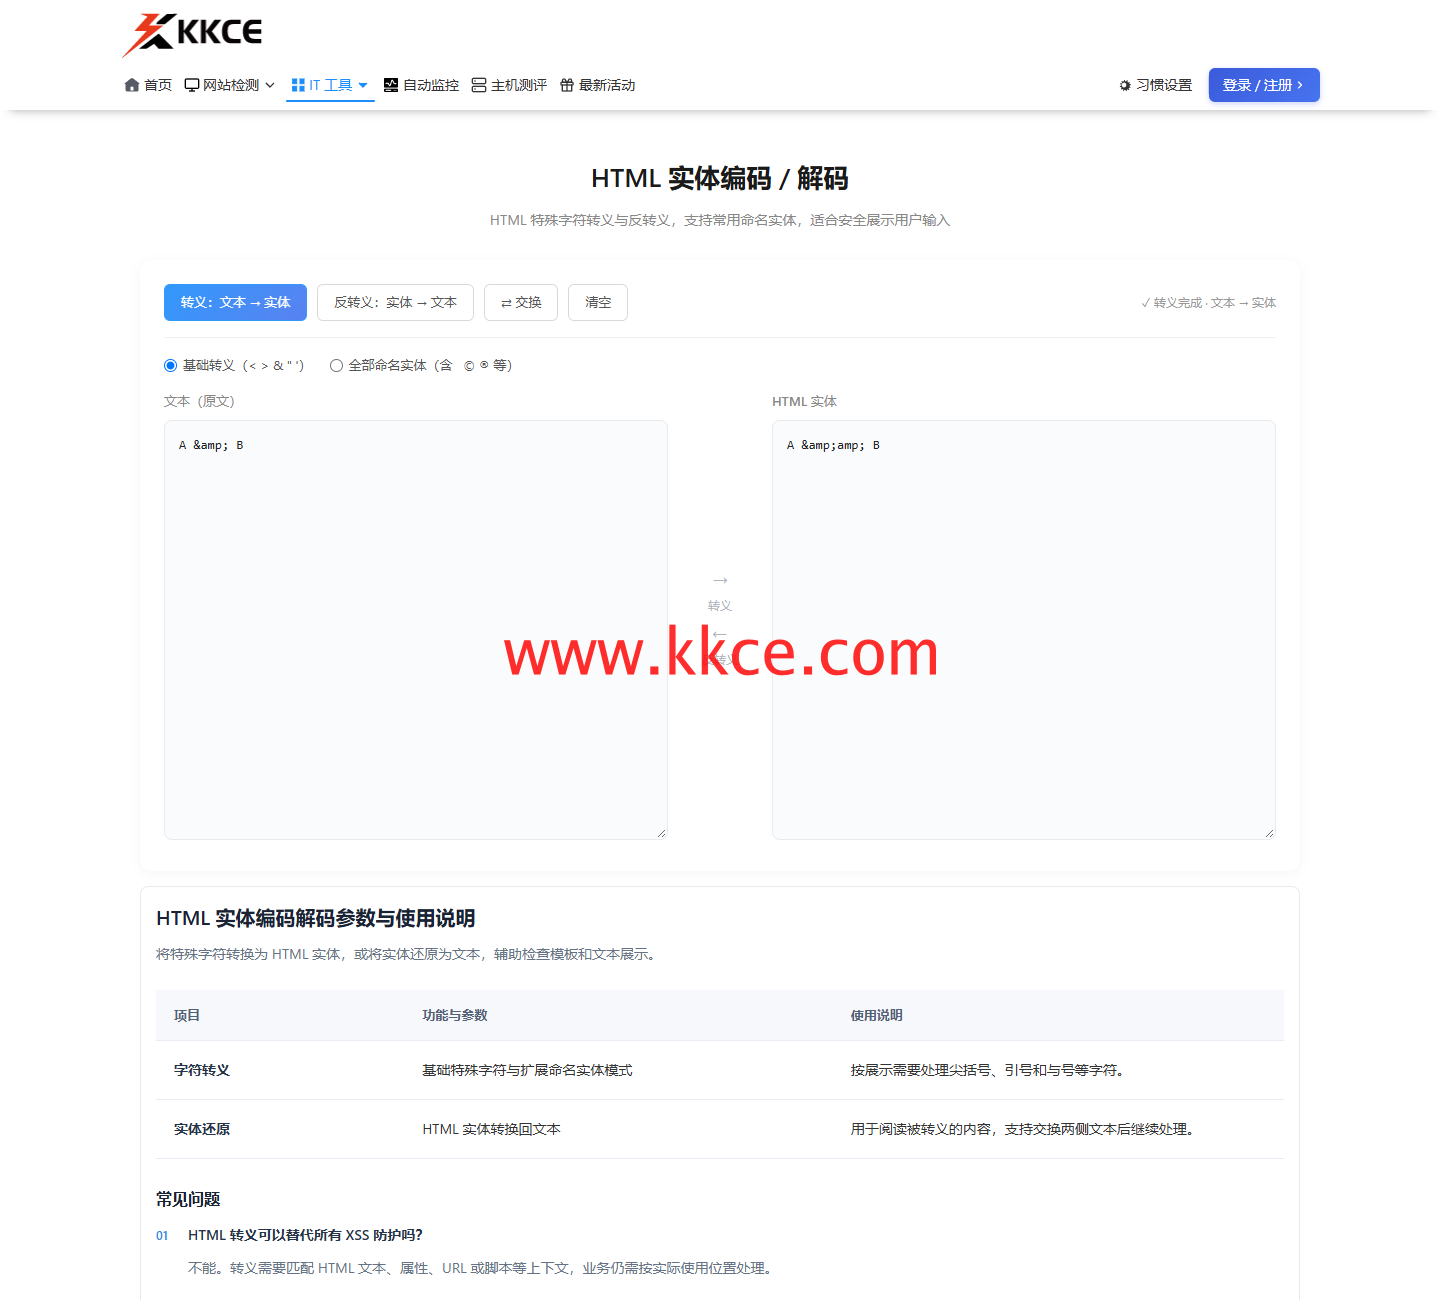 2026年11月7日,www.kkce.com 实操截图。主图展示第二次编码;下图为第一次编码,便于比较实体层级。
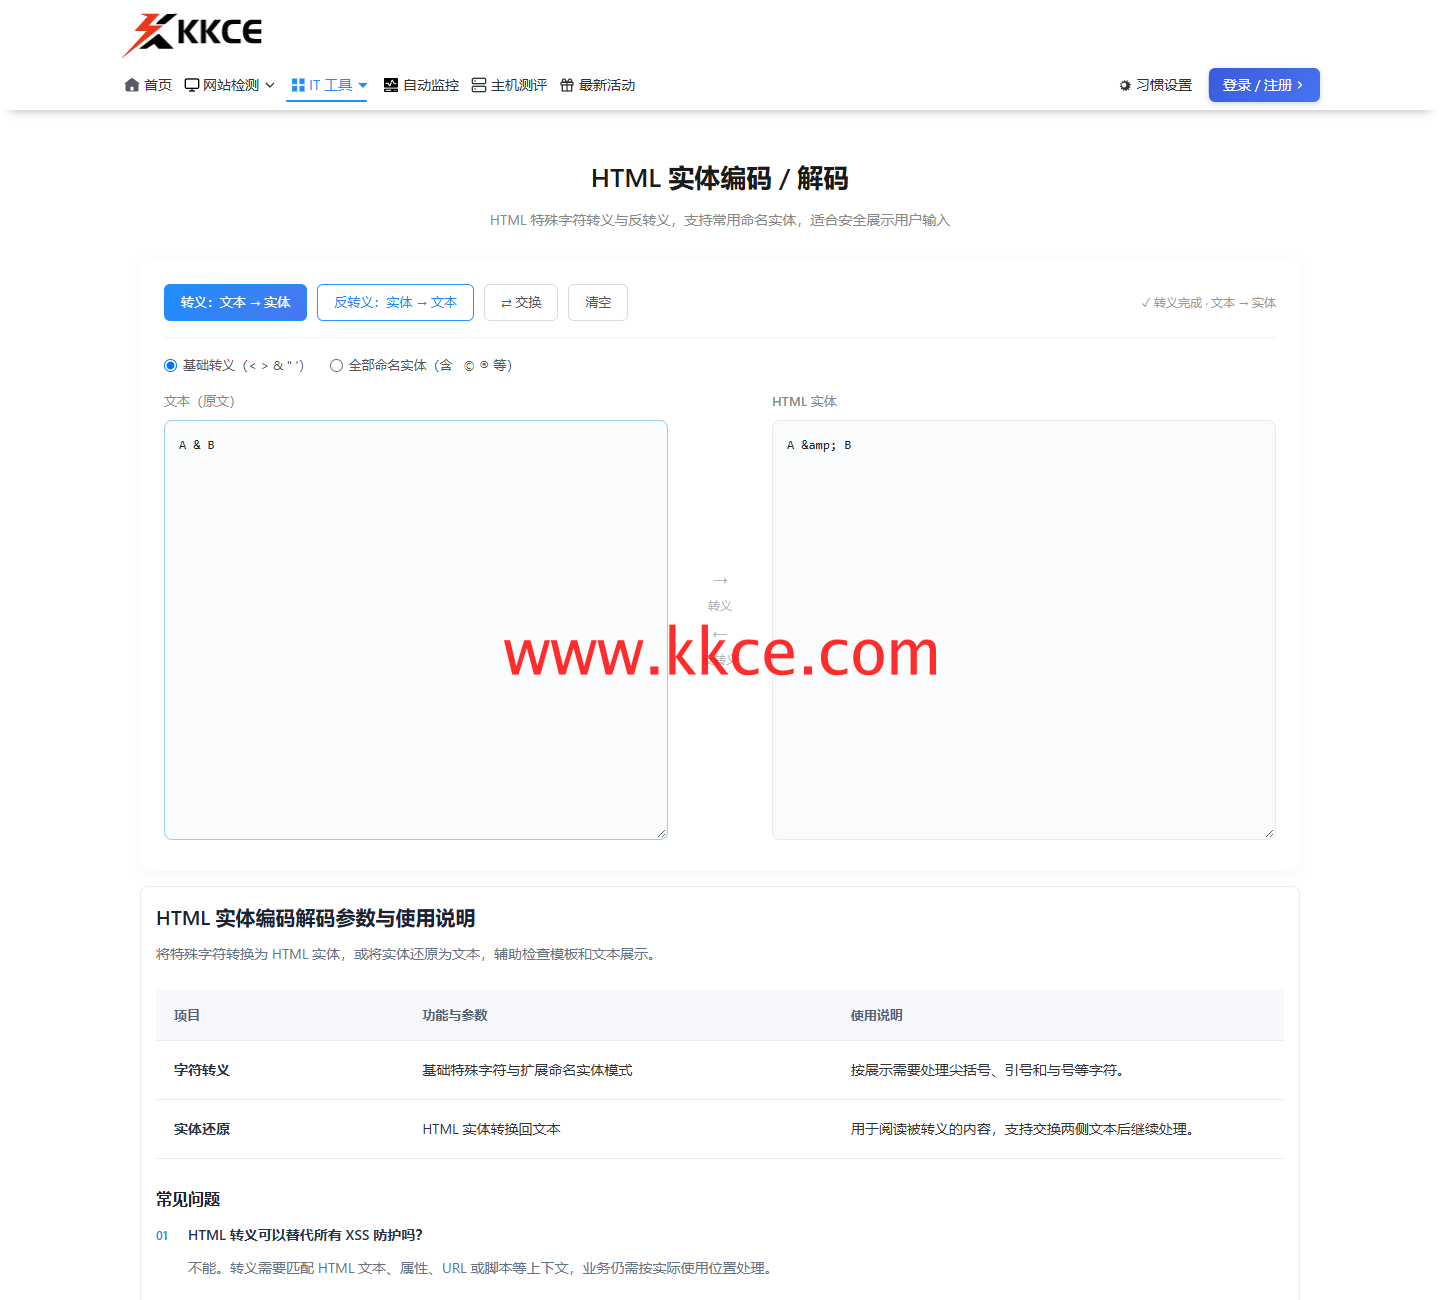 第一轮A & B变为带amp实体的表示;再次作为原文编码会增加层级。
两次输入可以看清累积过程
在KKCE HTML实体转换先将A & B编码为A & B,再把后者作为新输入,得到A & B。两张截图保留各轮输入输出。这里展示的是实体文字的变化,阅读正文中的拼写时,应区分页面显示字符与HTML源代码。
编码后的实体也含有需要处理的符号
编码器通常无法凭外观判断与号来自用户原文还是上游已经处理过的实体。如果输入边界没有约定,再次执行就会产生多一层表示。先追踪内容何时从原文变成HTML安全输出,比在显示端临时替换amp更容易找到根因。
存储与渲染要有清晰合同
某些系统保存原始文字,再由模板负责输出;某些历史数据则已经带有实体。迁移时应标记来源与处理方式,不能把两类内容混在一起继续统一编码。若允许富文本,还需要独立的内容清理规则,不能仅凭实体转换判断整个片段是否合适。
修正也要匹配所在上下文
不要循环解码直到肉眼可读,那可能重新引入具有特殊意义的字符。HTML正文、属性或其他嵌入位置需要各自恰当的处理。快快测可帮助复现公开样例的层次变化,生产修复则应以一组包含原始与号、实体和特殊符号的样本验证结果。
上一篇:
换行看着一样,字节为何不同?
下一篇:
Base64解码为何报UTF-8错误?
