
robots.txt检查怎么做?KKCE 辅助排查百度与必应抓取受限
robots.txt检查要确认正确主机的根目录文件能否访问,并按爬虫组和路径理解 Allow、Disallow 规则。它主要用于声明抓取约定,不是账号鉴权机制,也不能单独保证页面被收录或移除。用 KKCE 观察文件与页面的外部访问,再到百度、必应站长平台核对抓取,能够形成更完整的诊断。
robots.txt检查的四个关键点
| 项目 | 检查方法 |
|---|---|
| 文件位置 | 按协议、主机和端口访问根目录 /robots.txt |
| 响应 | 确认实际 HTTP 状态及文件内容,排除登录页或安全挑战 |
| 规则匹配 | 区分 User-agent 组、路径与 Allow/Disallow |
| 目标 URL | 核对页面本身的状态、索引指令及内链可发现性 |
以 KKCE 实际文件为例
2026 年 11 月 7 日实际访问 KKCE robots.txt,返回 HTTP 200。文件包含 User-agent: *、Allow: /、Disallow: /preference_settings,以及 Sitemap: https://www.kkce.com/sitemap.xml。这是当次公开文件快照,不能据此替代对某个搜索平台的实际抓取确认。
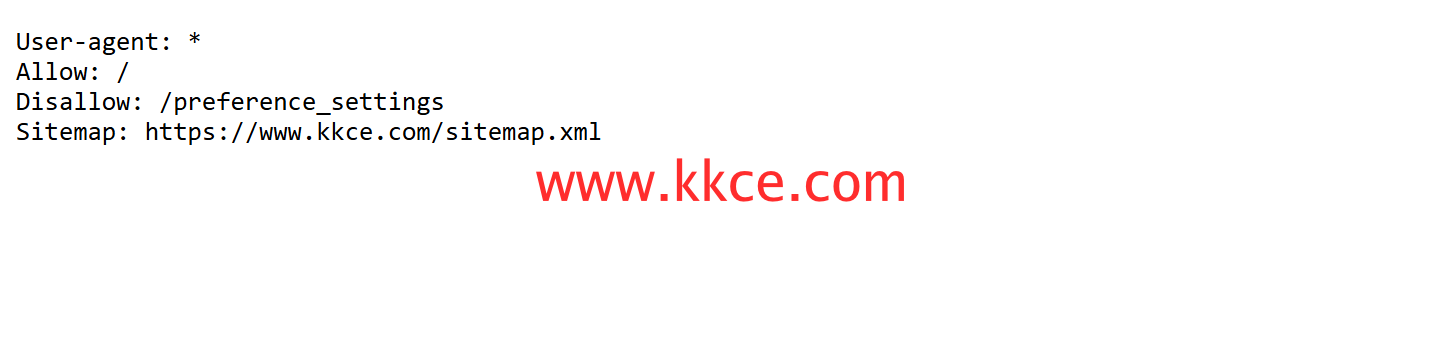 直接访问根目录 robots.txt 的截图,内容可能随网站配置更新(KKCE 官网实拍,2026 年 11 月 7 日)
站长自查的建议顺序
- 先确定发生问题的是 www、非 www、HTTP 还是 HTTPS 主机。
- 访问对应 robots 文件,核对是否误拦了文章目录或必要资源。
- 使用 KKCE 网站测速 检查目标文章 URL 的状态与可访问性。
- 检查页面源代码与响应头中的索引控制指令,注意与 robots 抓取规则的区别。
- 在 百度搜索资源平台和 Bing Webmaster Tools核对当前可用的抓取、URL 检查及站点地图反馈。
为什么禁止抓取不等于禁止索引?
搜索系统可能从其他页面发现某个地址。robots 限制的是访问约定,不能简单当作删除索引工具;若爬虫无法访问页面,也可能无法看到页面中的 noindex 指令。不同目标应使用对应机制,并依据搜索平台正式说明操作。
此外,robots.txt 公开可读,不能用于隐藏后台或保护敏感数据。后台和私有接口应使用真正的认证与访问控制。规则语法和匹配可参考 Robots Exclusion Protocol RFC 9309。
常见问题
允许抓取后会立即收录吗?
不会由这一项决定。页面发现、内容、稳定响应和搜索系统处理都影响后续结果。
KKCE 能查看搜索引擎内部抓取状态吗?
外部拨测不能代替搜索平台数据。它帮助检查访问基础条件,具体抓取与索引反馈仍需登录已验证站点查看。
将 KKCE 的外部访问结果与平台反馈对应,可以更快排除 robots 误配置造成的抓取障碍。
资料核对日期:2026 年 11 月 7 日。资料来源与工具入口:
