
搜索引擎抓取403怎么排查?KKCE 请求差异与防护日志核对
搜索引擎抓取403应先确认是哪一层拒绝请求,再核对真实爬虫身份、路径与防护日志。本地能打开,不代表爬虫能够读取;把 User-Agent 改成搜索引擎名称,也不能证明来自真实爬虫。KKCE 的多节点访问与高级请求选项适合比较外部请求差异,搜索平台和服务端日志则用于核实抓取事实。
403 排查先分清拒绝来自哪里
| 位置 | 常见检查项 |
|---|---|
| CDN 或 WAF | IP、地区、速率、行为挑战与托管规则 |
| 反向代理 | 虚拟主机、路径限制和访问名单 |
| 应用 | 登录、权限、来源校验和签名 |
| 文件服务 | 目录与文件权限、索引规则 |
| 请求条件 | 方法、请求头、Cookie 与跳转前后差异 |
如何用 KKCE 保留外部访问证据?
- 从搜索平台提供的失败 URL 与时间入手,避免只测首页。
- 使用 KKCE 网站测速 检查不同节点的状态,记录目标、时间、响应地址和请求方法。
- 在高级选项中按需要设置 UA、Referer 或 Cookie,分别保存结果,避免一次改变多个条件。
- 将节点异常时间与 CDN、WAF、代理及应用日志对应,寻找具体命中规则。
- 调整准确的规则后,以实际页面和平台反馈复测,同时保留必要的安全限制。
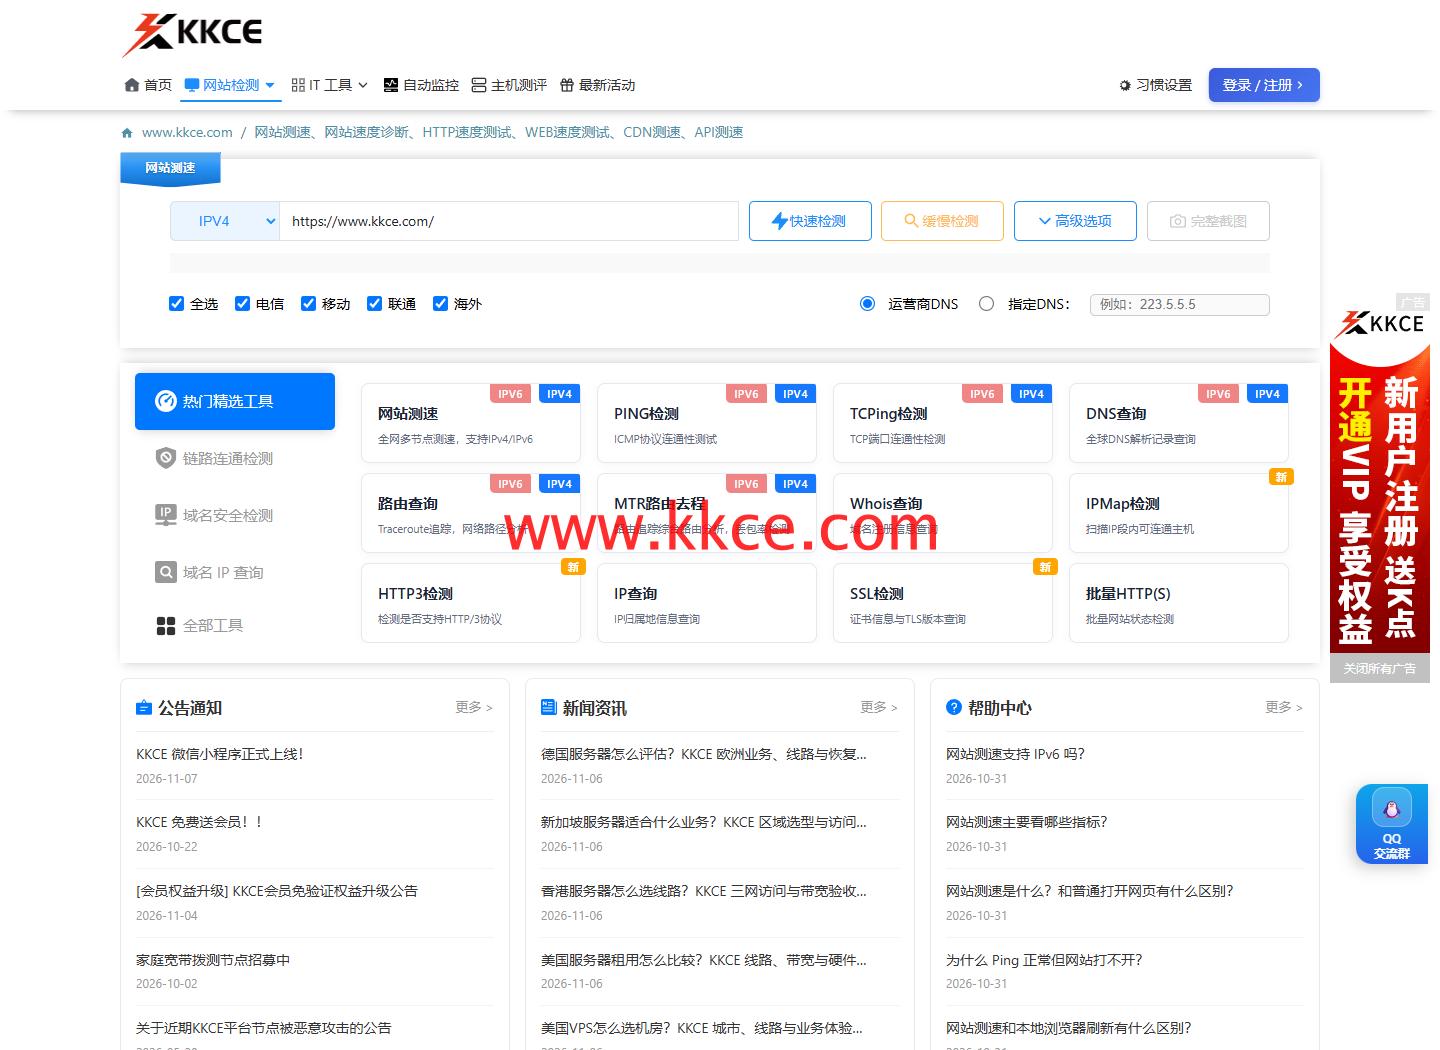 参数对照用于排查条件差异;填写爬虫 UA 不等于真实搜索爬虫访问(KKCE 官网实拍,2026 年 11 月 7 日)
为什么不能只按 User-Agent 放行?
User-Agent 可由客户端自填。任何请求都可能声称来自某个爬虫,简单放行会扩大访问范围。应依据百度、必应当前官方的身份验证方式,结合来源 IP、适用的反向与正向 DNS 校验或官方地址资料验证,再配置范围明确的策略。
本次检查的是 KKCE 工具界面和正常官网请求,没有模拟站点发生搜索爬虫 403,也没有伪装成真实爬虫完成抓取。站长应以已验证的 百度搜索资源平台、Bing Webmaster Tools数据及服务端日志为准。
403 与 robots 禁止有什么不同?
403 是 HTTP 层拒绝请求;robots.txt 是抓取规则声明。即使 robots 允许访问,WAF 或应用仍可能返回 403;反过来,HTTP 200 也不说明爬虫按 robots 规则应该抓取该地址。排查时应分别检查。
常见问题
遇到爬虫403,应立即关闭全部防护吗?
不建议。先定位路径、身份与命中规则,再做限定调整,并验证正常业务和安全行为。
403 消失后会马上恢复索引吗?
不由状态码单项决定,还需观察重新抓取和搜索系统后续处理。
将 KKCE 的访问记录与真实爬虫日志对应,能更有效地区分请求差异、误拦截与业务权限问题。
继续阅读:网页状态异常的分层排查。
资料核对日期:2026 年 11 月 7 日。资料来源与工具入口:
