
正则单词边界能识别中文吗?
正则中的单词边界并不等于自然语言分词。在本页采用的JavaScript规则下,常规的反斜杠b依据单词字符与非单词字符的交界判断;它不会自动理解中文词语。因此给中文两侧加上这类边界,可能反而无法匹配,不能照搬英文样例就认定规则通用。
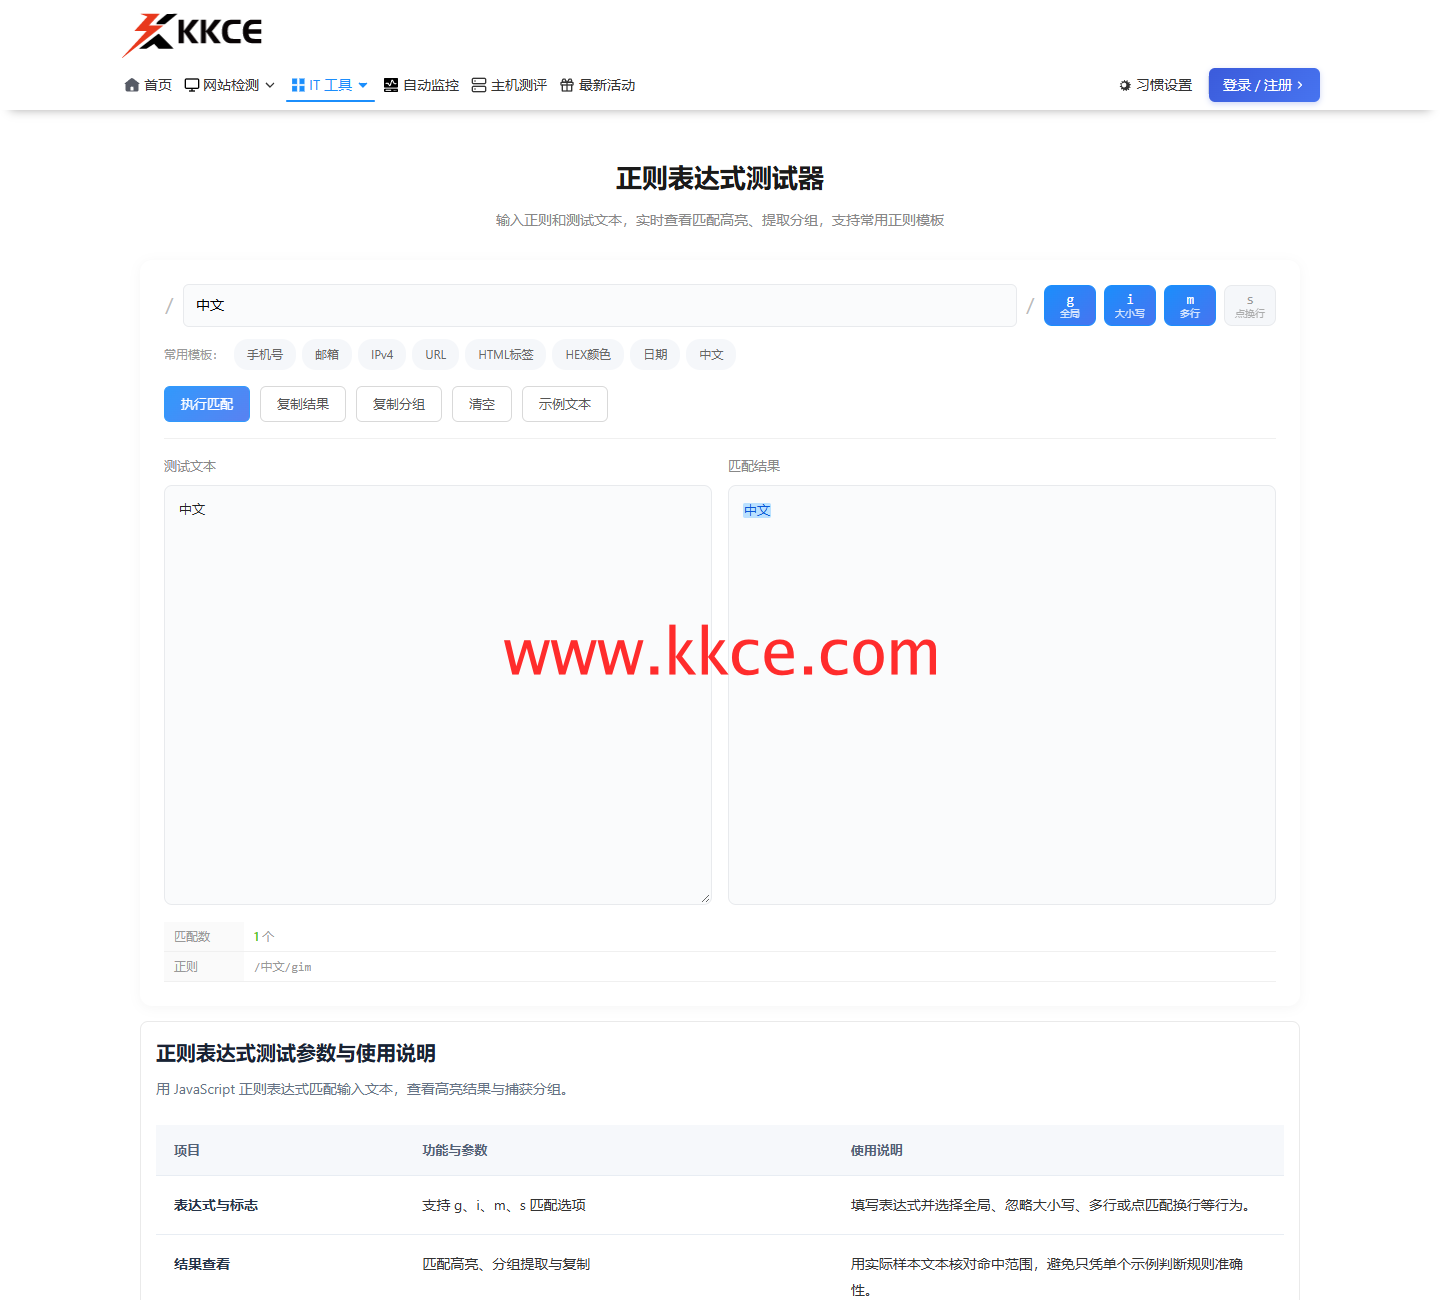 2026年11月7日,www.kkce.com 实操。主图为不带边界时的1个匹配;下图是相同文字带边界时的0个匹配。
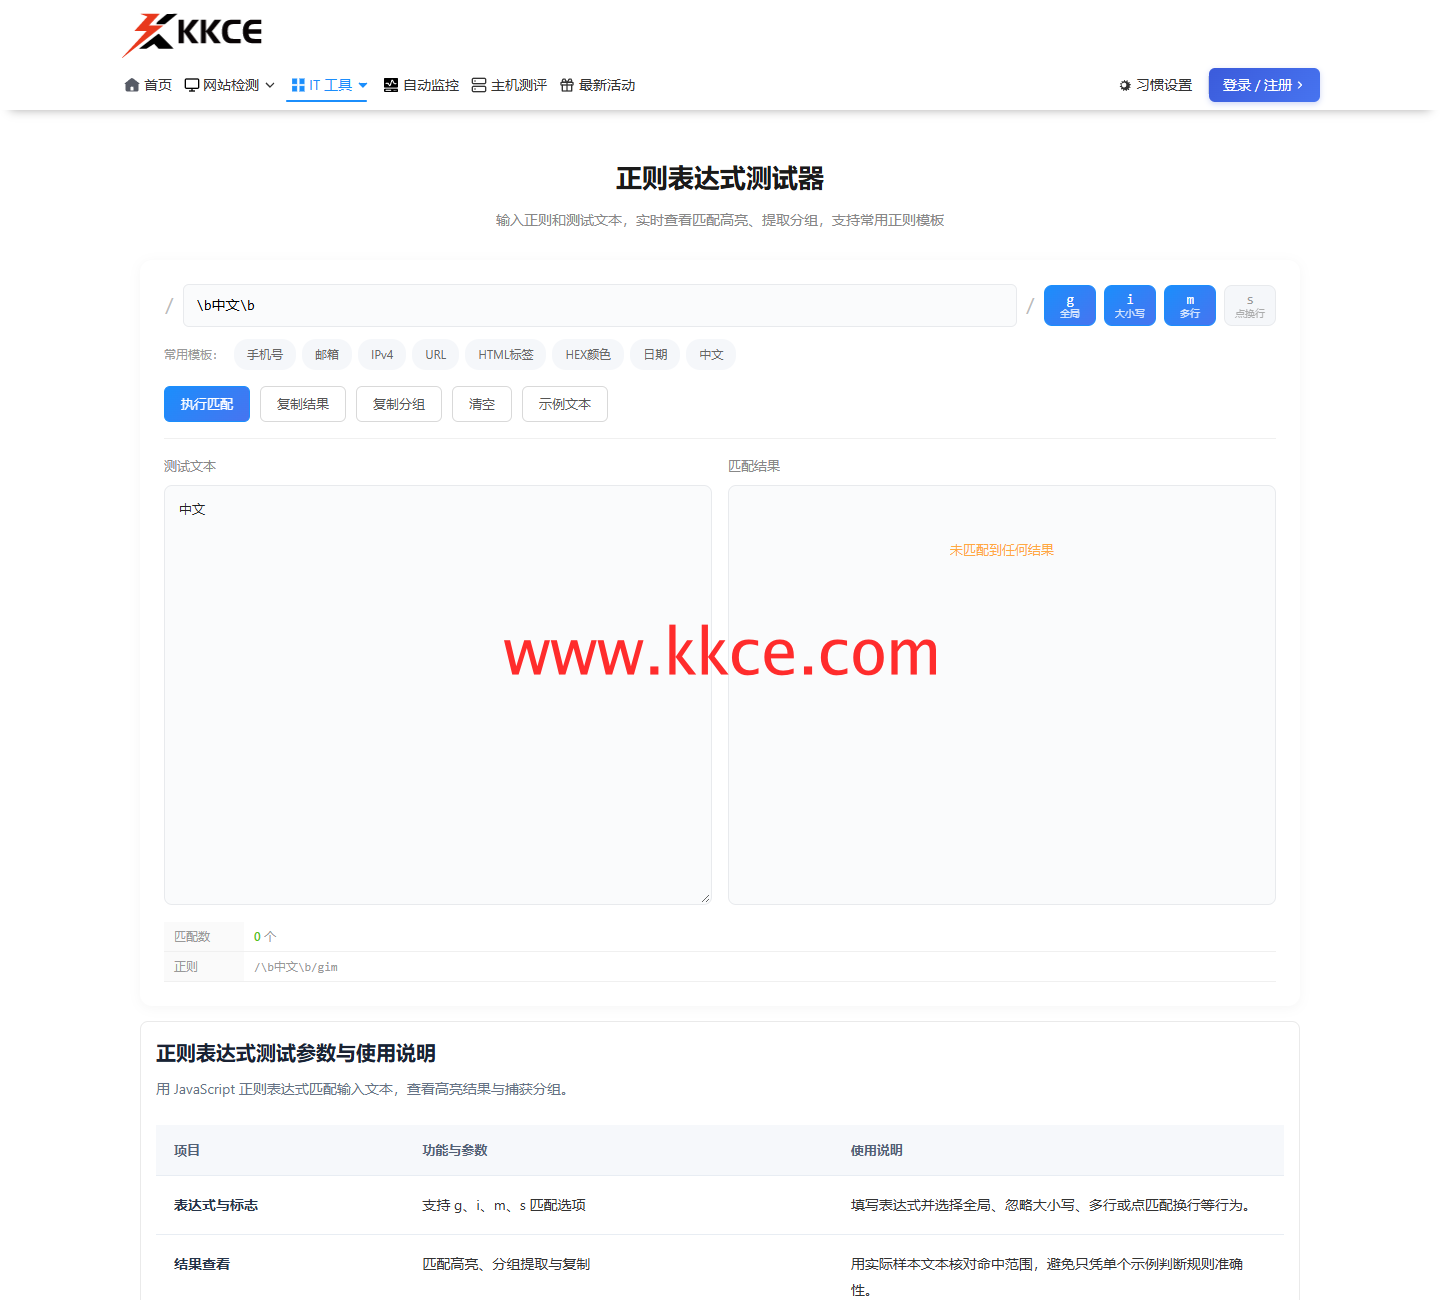 与主图相比,仅表达式两侧的边界条件不同,g、i、m选项保持原状。
保持文本不变只改边界条件
在KKCE正则测试器输入“中文”,使用\b中文\b得到0个匹配;移除两侧边界后得到1个。操作保留页面原有g、i、m选项,配图展示同一短文本的前后结果。该对照针对当前JavaScript引擎,不是对所有语言正则实现的统一结论。
为什么开头结尾也不一定算边界
在这个例子中,汉字并未被当成常规单词字符,字符串外侧也不形成所需的字符类别变化。于是看起来已经独立成词,表达式却不命中。问题来自边界定义,不是文字缺失,也不应靠随意增加空格掩盖。
先定义业务真正要限制的范围
若只是查找汉字片段,可使用对应文字或字符范围;若要限定整段输入,则应选择适合的整体匹配规则。识别自然语言词语时,还需要明确分词或分段方法,不能让一个正则边界承担没有定义的语言学任务。
迁移规则时带上反例一起验证
测试应包含纯中文、中文夹英文、数字及标点相邻等情况,核对命中位置而不只看有无结果。快快测可直观呈现匹配差异,目标服务使用的引擎仍需独立复现。只有字符类别和业务边界都写清楚,规则才容易维护。
上一篇:
JSON数字键为何自己换了顺序?
下一篇:
MD5一致,文件就一定可信吗?
